Với doanh nghiệp còn lưu nhiều hợp đồng, hồ sơ nhân sự, chứng từ hoặc tài liệu nghiệp vụ dưới dạng giấy, vấn đề không chỉ là lưu trữ mà còn là khả năng tìm lại nội dung bên trong tài liệu. Một tập hồ sơ đã scan nhưng chỉ tồn tại dưới dạng ảnh vẫn khiến nhân viên phải mở từng trang để kiểm tra.
Để chuyển tài liệu giấy thành văn bản tìm kiếm được, quy trình thực tế thường đi theo chuỗi giấy → scan/chụp → ảnh tài liệu → OCR → lớp văn bản → lập chỉ mục → tìm kiếm. Tesseract OCR đảm nhiệm phần nhận dạng chữ từ ảnh; các bước lập chỉ mục và tìm kiếm cần được thực hiện bởi hệ thống quản lý tài liệu hoặc phần mềm được tích hợp thêm.
Tesseract OCR là một OCR engine mã nguồn mở gồm thư viện libtesseract và chương trình dòng lệnh tesseract. Kho mã nguồn chính tesseract-ocr/tesseract có khoảng 76 nghìn sao trên GitHub tại thời điểm kiểm tra ngày 05/09/2026, sử dụng C++ và phát hành theo Apache License 2.0. Nguồn chính thức.
Tesseract hỗ trợ Unicode UTF-8 và dữ liệu ngôn ngữ cho hơn 100 ngôn ngữ. Công cụ có thể nhận các định dạng ảnh thông qua Leptonica và xuất văn bản thuần, hOCR, TSV, PDF cùng một số định dạng khác. Tài liệu chính thức của dự án cũng mô tả khả năng tạo PDF có ảnh trang và lớp văn bản ẩn để tìm kiếm. Nguồn chính thức.
Tesseract OCR là gì?
Tesseract OCR là một OCR engine mã nguồn mở dùng để nhận dạng ký tự quang học từ hình ảnh. Theo tài liệu dự án, Tesseract 4 đã bổ sung engine dựa trên mạng nơ-ron LSTM, đồng thời vẫn duy trì engine OCR cũ thông qua chế độ Legacy OCR Engine. Nguồn chính thức.
Điểm đáng chú ý là Tesseract không phải một phần mềm văn phòng có giao diện đồ họa hoàn chỉnh. Dự án cung cấp engine, chương trình dòng lệnh và API để nhà phát triển tích hợp vào ứng dụng riêng. Nếu cần giao diện, doanh nghiệp phải dùng một dự án bên thứ ba hoặc tự xây dựng lớp giao diện phù hợp.
Về triển khai, Tesseract có thể được cài từ gói dựng sẵn hoặc biên dịch từ mã nguồn. Nhà phát triển cũng có thể sử dụng API của libtesseract để đưa OCR vào hệ thống quản lý tài liệu, phần mềm nghiệp vụ hoặc một pipeline xử lý hồ sơ. Tài liệu cài đặt chính thức cũng cho biết các cấu hình tạo đầu ra như PDF, TSV, hOCR và ALTO được cài cùng hệ thống. Nguồn chính thức.
Ngoài tài liệu của dự án, thông tin về giấy phép Apache License 2.0 của Tesseract có thể được đối chiếu với trang Apache License của Apache Software Foundation. Đây là nguồn tham khảo bên ngoài cho việc kiểm tra điều kiện sử dụng phần mềm mã nguồn mở.
Quy trình chuyển tài liệu giấy thành văn bản tìm kiếm
Quy trình bắt đầu từ tài liệu giấy. Doanh nghiệp dùng máy scan hoặc thiết bị chụp để tạo ảnh từng trang. Ảnh sau đó được đưa vào Tesseract cùng dữ liệu ngôn ngữ và các tùy chọn phân tích bố cục trang phù hợp.
Bạn đưa ảnh tài liệu vào → Tesseract phân tích và nhận dạng ký tự → hệ thống lưu văn bản hoặc định dạng OCR → lập chỉ mục → người dùng tìm kiếm nội dung.
Điểm cần phân biệt là Tesseract chỉ thực hiện phần OCR. Một file ảnh sau khi được nhận dạng không tự trở thành một kho tài liệu có chức năng tìm kiếm. Doanh nghiệp cần thêm lớp lưu văn bản, metadata và lập chỉ mục, hoặc kết hợp Tesseract với hệ thống quản lý tài liệu đã có sẵn.
Chất lượng ảnh đầu vào có vai trò rất lớn. Tài liệu bị mờ, nghiêng, thiếu sáng, nhiễu hoặc có bố cục phức tạp có thể làm giảm chất lượng OCR. Chính tài liệu của dự án cũng lưu ý rằng trong nhiều trường hợp cần cải thiện chất lượng hình ảnh trước khi đưa vào Tesseract để có kết quả tốt hơn.
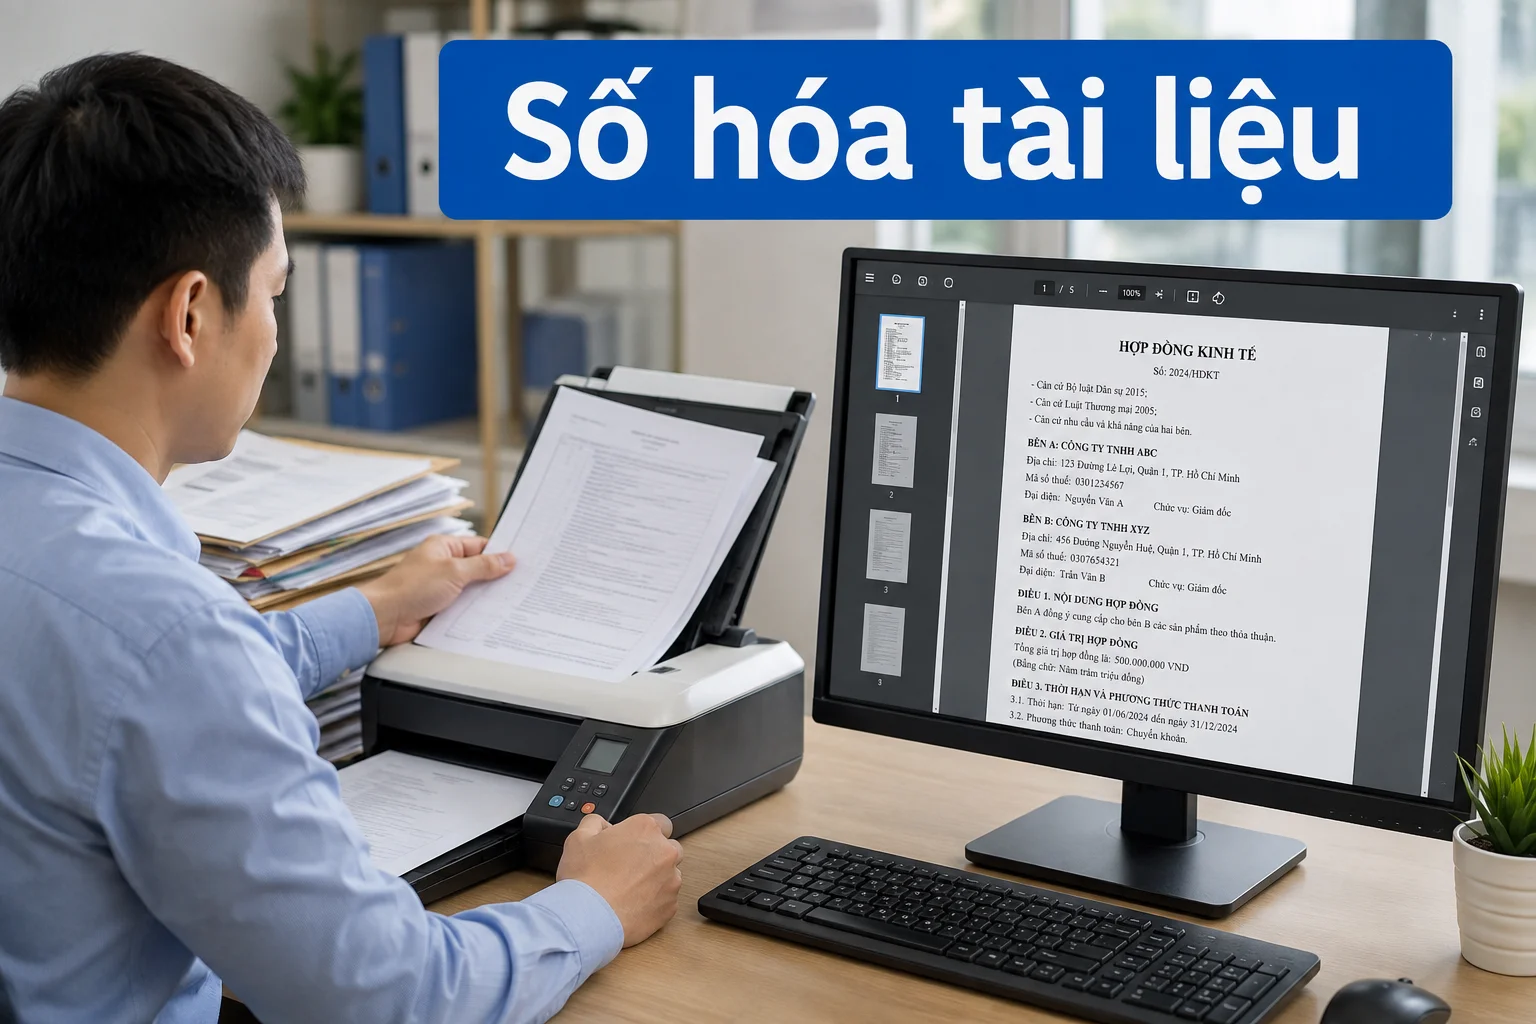
Trong một quy trình doanh nghiệp, vì vậy không nên hiểu OCR là bước duy nhất. Có thể hình dung pipeline gồm scan tài liệu, tiền xử lý ảnh, nhận dạng OCR, kiểm tra kết quả, lưu văn bản và lập chỉ mục. Tesseract đảm nhiệm phần nhận dạng, còn các bước xung quanh có thể được xây dựng theo yêu cầu của hệ thống.
Theo tài liệu hướng dẫn chính thức của Tesseract, chất lượng ảnh đầu vào và việc xử lý ảnh phù hợp có thể ảnh hưởng đến kết quả nhận dạng. Vì vậy, nguồn tham khảo bên ngoài nên được dùng để đối chiếu nguyên tắc OCR tổng quát, nhưng việc đánh giá cuối cùng vẫn nên dựa trên tập tài liệu thực tế của doanh nghiệp.
Khả năng nhận dạng tiếng Việt
Câu trả lời là có. Tesseract có hỗ trợ Unicode UTF-8 và dữ liệu ngôn ngữ cho hơn 100 ngôn ngữ. Tài liệu chính thức của dự án cho biết Tesseract 4 có dữ liệu mô hình cho hơn 100 ngôn ngữ và 35+ hệ chữ. Nguồn chính thức.
Với tài liệu tiếng Việt, doanh nghiệp cần quan tâm đặc biệt đến chất lượng scan và dữ liệu ngôn ngữ được cấu hình. Chữ có dấu khiến những lỗi nhỏ ở hình ảnh có thể ảnh hưởng đến ký tự đầu ra. Vì vậy, việc kiểm thử bằng chính mẫu hợp đồng, biểu mẫu, hóa đơn hoặc hồ sơ thực tế của doanh nghiệp quan trọng hơn việc chỉ thử vài trang tài liệu đẹp.
Tesseract cũng có khả năng được huấn luyện để nhận dạng thêm ngôn ngữ hoặc tinh chỉnh mô hình ngôn ngữ hiện có. Đây là điểm hữu ích nếu doanh nghiệp có tài liệu đặc thù hoặc cần mở rộng bộ nhận dạng trong tương lai. Nguồn chính thức.
Đối với tài liệu có nhiều dấu tiếng Việt, nên kiểm tra riêng các trường dễ phát sinh sai lệch như họ tên, địa chỉ, mã hồ sơ và nội dung hợp đồng. Đây là bước đánh giá chất lượng đầu ra, không nên suy ra chỉ từ việc engine có hỗ trợ ngôn ngữ tiếng Việt.
Làm được gì
Trường hợp 1 – Tìm kiếm hồ sơ: Một doanh nghiệp có phòng hành chính lưu nhiều hồ sơ giấy. Nhân viên scan hồ sơ thành ảnh rồi đưa vào pipeline có Tesseract. Văn bản OCR được lưu cùng tài liệu và lập chỉ mục. Khi cần tìm tên, mã hồ sơ hoặc nội dung hợp đồng, nhân viên có thể tìm trên lớp văn bản thay vì mở từng trang ảnh.
Trường hợp 2 – Hỗ trợ nhập liệu chứng từ: Một công ty có bộ phận kế toán thường xuyên tiếp nhận chứng từ giấy. Tesseract có thể tạo văn bản ban đầu từ bản scan, sau đó chuyển kết quả cho bước kiểm tra và trích xuất trường dữ liệu trước khi đưa vào phần mềm nghiệp vụ. Cách này giúp tách rõ phần nhận dạng tự động khỏi phần con người xác nhận.
Trường hợp 3 – Xử lý kho tài liệu hàng loạt: Phòng pháp chế của doanh nghiệp vừa và lớn có kho hợp đồng cũ ở dạng ảnh. Tesseract có thể trở thành một thành phần trong quá trình xử lý hàng loạt: nhận ảnh, nhận dạng nội dung, tạo dữ liệu OCR, gắn metadata và chuyển kết quả sang hệ thống quản lý tài liệu để lập chỉ mục. Những tài liệu quan trọng vẫn nên có bước kiểm tra chất lượng trước khi sử dụng kết quả OCR cho nghiệp vụ.
Ghép với công cụ khác
Paperless-ngx: Đây là ví dụ phù hợp hơn với nhu cầu số hóa và tìm kiếm tài liệu. Tesseract có thể nằm ở lớp nhận dạng chữ, còn Paperless-ngx đảm nhiệm phần quản lý tài liệu, lập chỉ mục và lưu trữ. Dự án Paperless-ngx tự mô tả là hệ thống có khả năng scan, lập chỉ mục và lưu trữ tài liệu vật lý. Kho chính paperless-ngx/paperless-ngx có 44393 sao, sử dụng Python và giấy phép GNU General Public License v3.0; dữ liệu được kiểm tra ngày 05/09/2026. Nguồn chính thức.
ClickHouse: Đây là trường hợp mở rộng, không phải tích hợp phổ biến cho bài toán OCR tài liệu. Nếu doanh nghiệp cần phân tích dữ liệu đã trích xuất từ khối lượng lớn hồ sơ, Tesseract có thể đứng ở đầu pipeline để biến ảnh thành văn bản; sau các bước làm sạch và cấu trúc hóa, dữ liệu phù hợp mới được đưa vào lớp phân tích. ClickHouse phù hợp hơn ở vai trò cơ sở dữ liệu phân tích sau OCR. Kho ClickHouse/ClickHouse có 49570 sao, sử dụng C++ và giấy phép Apache License 2.0; dữ liệu được kiểm tra ngày 05/09/2026. Nguồn chính thức.
f/prompts.chat: Dự án này không phải công cụ OCR hay hệ thống quản lý tài liệu, nên không nên xem là thành phần thay thế Tesseract. Với một pipeline tự động hóa rộng hơn, kho f/prompts.chat có 167859 sao, sử dụng HTML và giấy phép Other; dữ liệu được kiểm tra ngày 05/09/2026. Đây là ví dụ về một dự án cùng nhóm công cụ hỗ trợ AI nhưng khác lớp chức năng, giúp phân biệt rõ OCR với các công cụ phục vụ quy trình AI.
Với doanh nghiệp có yêu cầu tích hợp riêng, Việt Tiến IT có thể xem xét Tesseract như một thành phần trong dịch vụ Phát triển phần mềm theo yêu cầu hoặc AI & Automation, thay vì coi nó là một ứng dụng độc lập phải đáp ứng toàn bộ bài toán quản lý tài liệu.
So với dự án tương tự
tên | loại giải pháp | ngôn ngữ | giấy phép | khác nhau ở đâu |
|---|---|---|---|---|
Tesseract OCR | OCR engine | C++ | Apache License 2.0 | Chuyên nhận dạng chữ từ hình ảnh, có CLI và API để tích hợp vào ứng dụng. |
Hệ thống quản lý tài liệu | Python | GNU General Public License v3.0 | Tập trung vào số hóa, lập chỉ mục, lưu trữ và tìm kiếm tài liệu. | |
OCRmyPDF | Công cụ xử lý PDF + OCR | Python | Mozilla Public License 2.0 | Tập trung bổ sung lớp OCR có thể tìm kiếm vào PDF, phù hợp khi quy trình làm việc xoay quanh tài liệu PDF. |
Bảng trên cho thấy Tesseract và các giải pháp liên quan có thể nằm ở những lớp khác nhau trong cùng một kiến trúc. Tesseract tập trung vào nhận dạng chữ; Paperless-ngx tập trung vào quản lý và tìm kiếm tài liệu; còn OCRmyPDF tập trung vào quy trình xử lý PDF có OCR. Vì vậy, lựa chọn không chỉ phụ thuộc vào độ chính xác OCR mà còn vào việc doanh nghiệp đang cần một engine, một công cụ xử lý PDF hay một hệ thống quản lý tài liệu hoàn chỉnh.
Khi tham khảo các dự án mã nguồn mở, doanh nghiệp cũng nên kiểm tra trực tiếp kho mã nguồn, giấy phép và trạng thái cập nhật thay vì chỉ dựa vào số sao. Các số liệu GitHub trong bài được sử dụng như dữ liệu tham khảo tại thời điểm kiểm tra, không phải thước đo duy nhất cho mức độ phù hợp của giải pháp.
Nhận định của Việt Tiến IT
Từ góc nhìn triển khai, chúng tôi đánh giá Tesseract phù hợp khi doanh nghiệp muốn kiểm soát pipeline OCR và tích hợp sâu vào phần mềm nội bộ. Đây là lựa chọn đáng cân nhắc nếu đội kỹ thuật có khả năng vận hành mã nguồn mở, cần xử lý tài liệu tại hạ tầng của mình và không muốn phụ thuộc hoàn toàn vào một dịch vụ OCR bên ngoài.
Chúng tôi không khuyến nghị bắt đầu bằng suy nghĩ “cài Tesseract là số hóa xong”. Phần khó thường nằm ở khâu trước và sau OCR: chuẩn hóa ảnh scan, lựa chọn dữ liệu ngôn ngữ, xử lý bố cục, kiểm tra kết quả, lưu trữ và tìm kiếm. Với hồ sơ quan trọng, kết quả nhận dạng nên được kiểm tra theo tỷ lệ hoặc theo quy tắc nghiệp vụ trước khi dùng cho quyết định chính thức.
Một rủi ro khác là kỳ vọng quá cao với tài liệu thực tế. Một bộ tài liệu gồm ảnh rõ nét, bố cục ổn định sẽ khác đáng kể so với tài liệu cũ bị nhòe, lệch hoặc có nhiều thành phần phức tạp. Do đó, cách làm thực tế là lấy một tập mẫu đại diện cho tài liệu doanh nghiệp, chạy thử, đo lỗi và xác định ngưỡng chấp nhận trước khi triển khai hàng loạt.
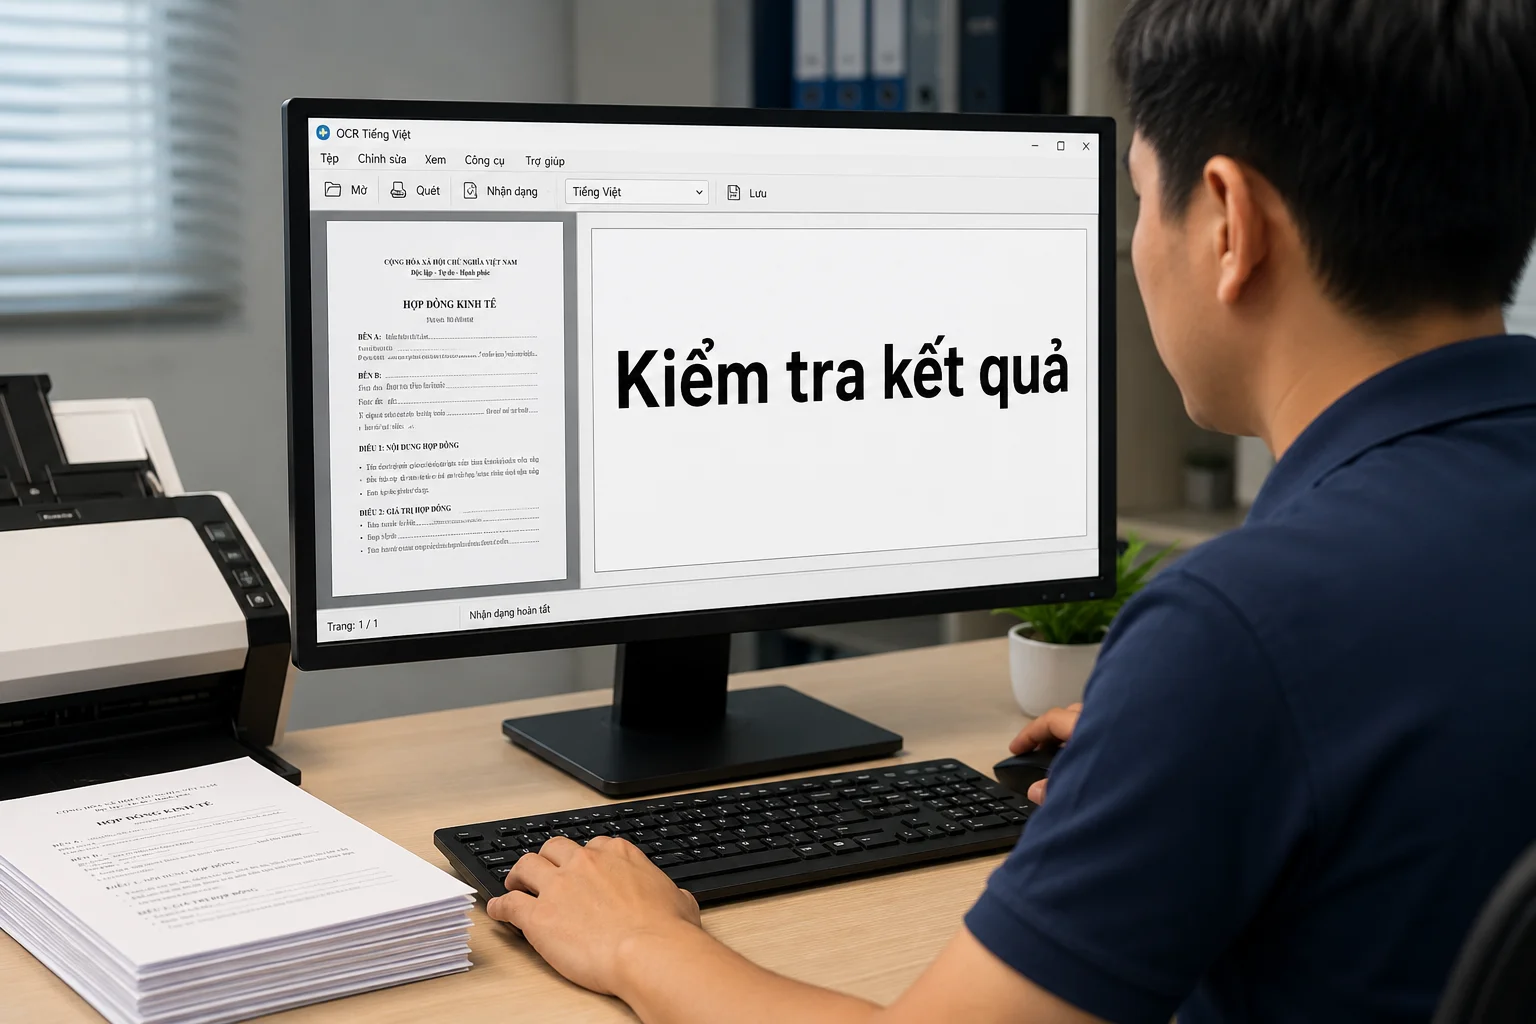
Tesseract cũng không có sẵn giao diện đồ họa theo dự án. Nếu người dùng cuối cần màn hình kéo-thả, theo dõi tiến trình, tìm kiếm hồ sơ hoặc sửa lỗi OCR, doanh nghiệp phải xây thêm lớp ứng dụng hoặc kết hợp với hệ thống quản lý tài liệu. Đây lại là điểm mà một dự án Phát triển phần mềm theo yêu cầu có thể tạo khác biệt: thiết kế quy trình phù hợp với cách phòng hành chính, kế toán hoặc pháp chế đang làm việc thay vì ép họ dùng công cụ kỹ thuật.
Với doanh nghiệp đang có máy chủ, lưu trữ hoặc môi trường cloud sẵn có, kiến trúc OCR cũng cần tính đến nơi xử lý ảnh, nơi lưu bản gốc, nơi lưu văn bản và cơ chế sao lưu. Nếu quy trình xử lý hồ sơ có tính lặp lại cao, có thể xem xét thêm AI & Automation để tự động chuyển tài liệu qua các bước đã xác định, nhưng vẫn giữ điểm kiểm soát của con người ở những công đoạn có rủi ro cao.
Tóm lại, Tesseract OCR phù hợp nhất khi mục tiêu là biến ảnh tài liệu thành dữ liệu chữ có thể tiếp tục xử lý và tìm kiếm, đồng thời doanh nghiệp muốn tự chủ về cách tích hợp. Nó không tự thay thế toàn bộ hệ thống quản lý tài liệu. Hiệu quả cuối cùng phụ thuộc vào chất lượng scan, dữ liệu ngôn ngữ, thiết kế pipeline và quy trình kiểm tra sau nhận dạng.
Câu hỏi thường gặp
Tesseract có thể xử lý tài liệu tiếng Việt có dấu không?
Có. Tesseract hỗ trợ Unicode UTF-8 và có dữ liệu ngôn ngữ cho tiếng Việt. Tuy nhiên, chất lượng scan, bố cục tài liệu và dữ liệu ngôn ngữ được cấu hình vẫn ảnh hưởng đáng kể đến kết quả nhận dạng.
Sau khi OCR, tài liệu có tự tìm kiếm được ngay không?
Không. Tesseract tạo dữ liệu chữ từ ảnh nhưng không tự cung cấp toàn bộ hệ thống quản lý và tìm kiếm tài liệu. Doanh nghiệp cần thêm lớp lưu trữ, metadata và lập chỉ mục hoặc kết hợp với phần mềm quản lý tài liệu.
Doanh nghiệp nên kiểm thử Tesseract trước khi số hóa hàng loạt như thế nào?
Nên chọn tập mẫu đại diện cho các loại hồ sơ thực tế, gồm cả trang rõ và tài liệu khó đọc, sau đó đo chất lượng nhận dạng, kiểm tra lỗi tiếng Việt và xác định ngưỡng chấp nhận trước khi triển khai diện rộng.
Tesseract khác gì một hệ thống quản lý tài liệu?
Tesseract là OCR engine tập trung nhận dạng chữ từ hình ảnh, trong khi hệ thống quản lý tài liệu còn xử lý lưu trữ, metadata, lập chỉ mục, tìm kiếm và quy trình sử dụng tài liệu.