OpenHuman là một dự án đáng chú ý trong nhóm trợ lý AI cá nhân vì cách tiếp cận không chỉ dừng ở việc hỏi và nhận câu trả lời. Theo tài liệu của dự án, OpenHuman hướng tới một “bộ não” có khả năng xây dựng bộ nhớ lâu dài về dữ liệu và bối cảnh của người dùng, một bộ điều phối các tác nhân AI và một công cụ nghiên cứu sâu. Tài liệu chính thức mô tả Memory Tree, kho Markdown tương thích với Obsidian và khả năng điều phối nhiều tác nhân trên các quy trình nhiều bước.
Với doanh nghiệp, điểm đáng quan tâm không phải là xem OpenHuman như một “AI toàn năng”, mà là xác định nó có thể đứng ở đâu trong quy trình công việc thực tế. Dữ kiện của dự án cho thấy OpenHuman đang ở giai đoạn thử nghiệm ban đầu. Vì vậy, cách tiếp cận phù hợp là thử nghiệm có kiểm soát trước khi đưa vào những quy trình quan trọng.
Dự án tinyhumansai/openhuman hiện có 39.293 sao theo dữ liệu được sử dụng trong bài. OpenHuman cũng không nên được hiểu là AGI, tức trí tuệ nhân tạo tổng quát, mà là một hướng kiến trúc tập trung vào bộ nhớ, điều phối tác nhân và nghiên cứu.
OpenHuman là gì?
OpenHuman có thể hiểu là một nền tảng trợ lý AI cá nhân được xây dựng theo hướng ưu tiên xử lý cục bộ, nghĩa là một phần bộ nhớ và dữ liệu được tổ chức trên thiết bị hoặc môi trường do người dùng kiểm soát. Thay vì coi mỗi phiên trò chuyện là một lần làm việc độc lập, dự án tập trung tạo ra bộ nhớ lâu dài về dữ liệu và bối cảnh của người dùng.
Trong kiến trúc được giới thiệu, phần “brain” hay bộ não xử lý sử dụng Memory Tree, tức cây bộ nhớ phân cấp, cùng Obsidian Wiki để tổ chức thông tin. Dữ liệu được sắp xếp thành các cây Markdown, còn SQLite được dùng cho kho bộ nhớ cục bộ. Các tệp Markdown tương thích với Obsidian giúp người dùng có thể mở, xem và chỉnh sửa dữ liệu bộ nhớ thay vì coi nó như một hộp đen.
Thành phần thứ hai là khả năng điều phối tác nhân AI. Tác nhân AI là một thành phần được giao nhiệm vụ cụ thể, chẳng hạn nghiên cứu, phân loại hoặc tổng hợp. OpenHuman hướng tới việc chạy nhiều tác nhân theo các quy trình, tức chuỗi bước xử lý có cấu trúc và có khả năng duy trì trạng thái.
Thành phần thứ ba là nghiên cứu sâu. Theo mô tả của dự án, hệ thống có thể khai thác dữ liệu của người dùng và thông tin trên web để phục vụ các nhiệm vụ nghiên cứu thay vì chỉ trả lời dựa trên một lượt hỏi đáp.
Cách trợ lý AI duy trì ngữ cảnh và xử lý nhiệm vụ
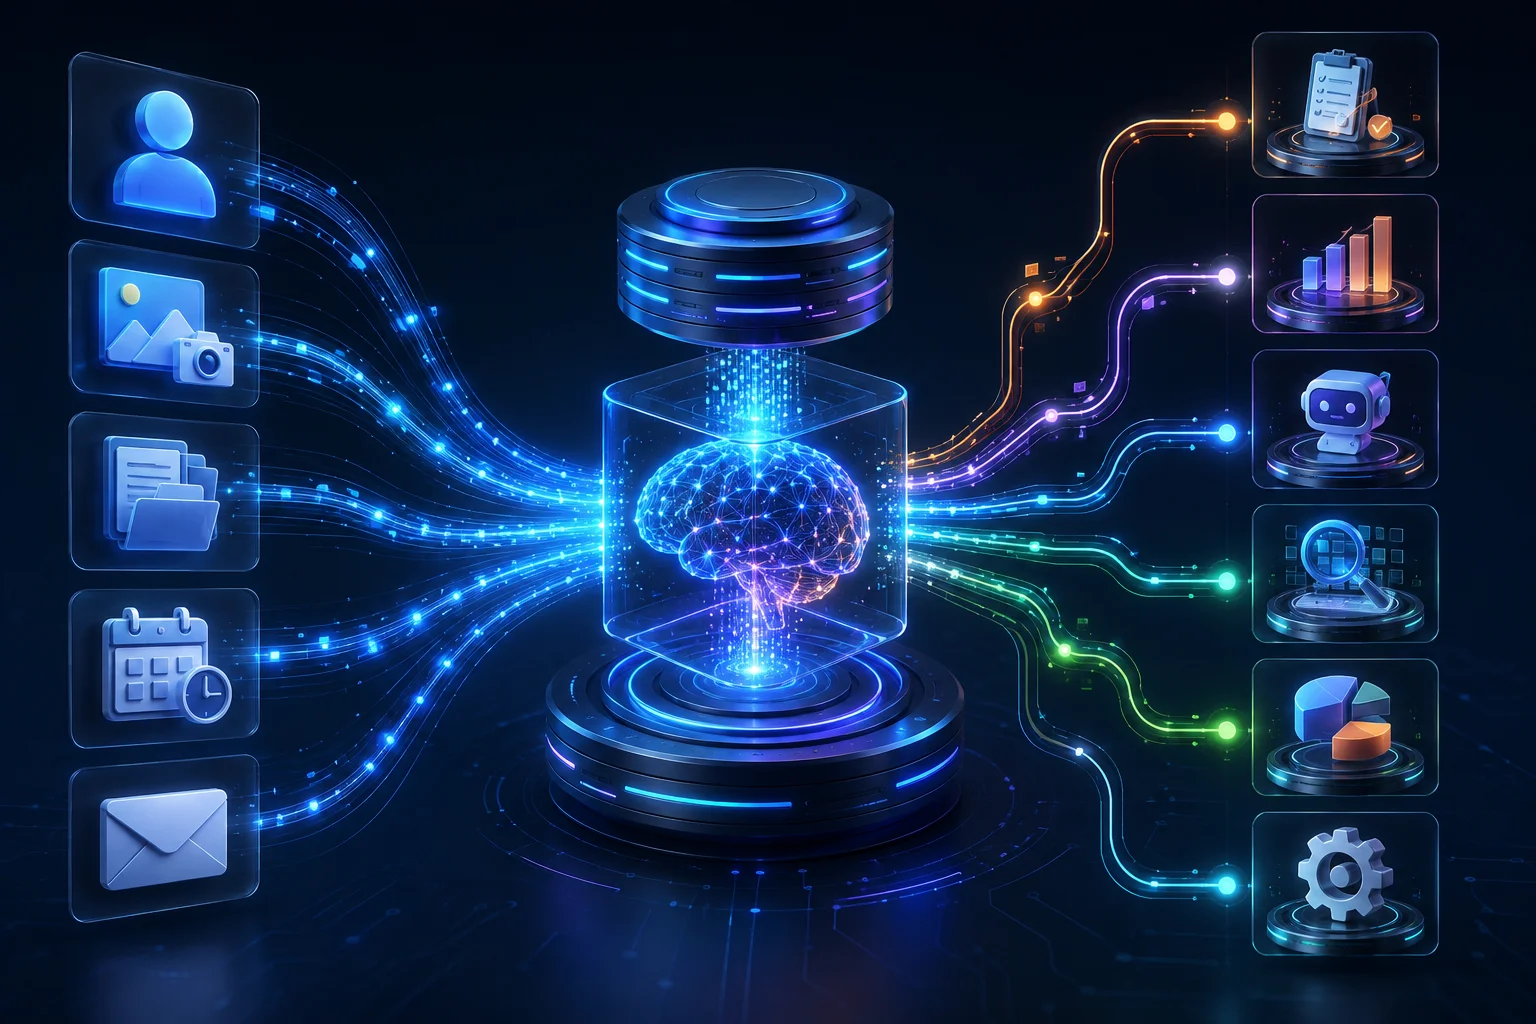
Có thể hình dung luồng xử lý theo cách đơn giản: người dùng cung cấp dữ liệu hoặc cấp quyền truy cập vào những nguồn cần thiết, bộ nhớ duy trì ngữ cảnh, sau đó các tác nhân AI và quy trình được điều phối để thực hiện nhiệm vụ. Điều này không có nghĩa OpenHuman mặc nhiên thu thập toàn bộ dữ liệu cá nhân; phạm vi dữ liệu phụ thuộc vào nguồn mà người dùng cấu hình và quyền truy cập được cấp.
Bạn đưa dữ liệu vào → hệ thống duy trì ngữ cảnh → tác nhân xử lý từng bước → bạn nhận kết quả để kiểm tra. Ví dụ, bạn đưa vào yêu cầu nghiên cứu cùng tài liệu liên quan → hệ thống tổ chức thông tin, sử dụng bộ nhớ và các tác vụ nghiên cứu phù hợp → kết quả được tổng hợp thành nội dung để người dùng tiếp tục sử dụng.
Điểm này hữu ích với những công việc hằng ngày có nhiều bước. Một nhiệm vụ có thể bắt đầu bằng đọc email hoặc tài liệu, tiếp tục bằng tìm thông tin, phân loại, đối chiếu, tổng hợp và cuối cùng tạo bản nháp. Khi đó, khả năng điều phối quy trình có thể hữu ích hơn một chatbot chỉ trả lời từng câu hỏi riêng lẻ.
Tuy nhiên, cần phân biệt giữa có khả năng điều phối và tự động hóa hoàn toàn. OpenHuman vẫn cần được kiểm thử trong bối cảnh thực tế. Doanh nghiệp nên kiểm tra từng quy trình, quyền truy cập dữ liệu và chất lượng đầu ra trước khi giao cho hệ thống những tác vụ có ảnh hưởng lớn.
Làm được gì với công việc hằng ngày?
Tình huống 1: tổng hợp công việc văn phòng. Nhân viên có thể phải đọc ghi chú, email và tài liệu trước khi chuẩn bị bản tóm tắt hoặc báo cáo. OpenHuman có thể được thử nghiệm ở khâu tổ chức bối cảnh, phân loại thông tin và điều phối các bước tổng hợp. Nhân viên vẫn kiểm tra kết quả trước khi gửi cho khách hàng hoặc cấp quản lý.
Tình huống 2: nghiên cứu cho marketing. Nhóm marketing có thể phải theo dõi tài liệu, ý tưởng nội dung và thông tin thị trường. Bộ nhớ lâu dài có thể giúp duy trì bối cảnh giữa các lần nghiên cứu, còn các tác nhân có thể đảm nhiệm những bước khác nhau như thu thập, phân loại và tổng hợp thông tin.
Tình huống 3: xử lý tài liệu kỹ thuật. Nhóm CNTT hoặc kỹ thuật thường xuyên làm việc với hướng dẫn nội bộ, ghi chú và nhiều đầu việc lặp lại có thể thử nghiệm OpenHuman như một lớp điều phối giữa dữ liệu và quy trình AI. Đây là cách tiếp cận phù hợp để kiểm chứng giá trị trước khi đầu tư một hệ thống AI và tự động hóa quy mô lớn.
Tình huống 4: theo dõi đầu việc cá nhân. Người dùng có thể thử nghiệm việc gom thông tin công việc, duy trì ngữ cảnh của các nhiệm vụ đang xử lý, nghiên cứu một chủ đề hoặc chuẩn bị danh sách việc cần làm. Các tác vụ có rủi ro thấp nên được ưu tiên trước khi mở rộng sang hành động có quyền thực thi.
Ghép với công cụ khác
OpenHuman có thể được xem như lớp điều phối, còn các công cụ khác đảm nhiệm những phần việc chuyên biệt. Tuy nhiên, cần phân biệt giữa tích hợp đã được xác nhận và kịch bản tích hợp giả định. Với hai dự án dưới đây, bài viết chỉ trình bày kiến trúc thử nghiệm dựa trên chức năng của từng dự án; không nên hiểu đây là connector, tức bộ kết nối, hoặc tích hợp trực tiếp đã được OpenHuman xác nhận.
Kết hợp với wshobson/agents
Kịch bản tích hợp giả định: OpenHuman có thể giữ vai trò tiếp nhận yêu cầu, duy trì ngữ cảnh và điều phối quy trình, trong khi các agent/plugin từ wshobson/agents đảm nhiệm tác vụ chuyên biệt. Về mặt kiến trúc đề xuất, dữ liệu có thể đi từ yêu cầu và bộ nhớ của OpenHuman → quy trình xác định tác nhân phù hợp → tác nhân xử lý nhiệm vụ → kết quả quay lại quy trình để tổng hợp và trả cho người dùng. Cần kiểm tra connector, API hoặc cơ chế gọi tương ứng trước khi triển khai thực tế.
Kết hợp với f/prompts.chat
Kịch bản tích hợp giả định: Với f/prompts.chat, điểm ghép có thể nằm ở lớp câu lệnh. Bộ prompt, tức câu lệnh hướng dẫn AI, có thể được dùng làm đầu vào cho một quy trình để chuẩn hóa cách tác nhân xử lý một số loại nhiệm vụ. Luồng kiến trúc đề xuất là yêu cầu người dùng → OpenHuman xác định quy trình → prompt và dữ liệu liên quan được đưa vào tác vụ → kết quả được trả lại để kiểm tra hoặc lưu vào bộ nhớ. Đây là phương án thử nghiệm, không phải khẳng định OpenHuman đã có tích hợp trực tiếp với f/prompts.chat.
Điểm quan trọng là không nên ghép công cụ chỉ để tăng số lượng thành phần. Mỗi kết nối cần có mục đích rõ: dữ liệu nào đi vào, tác nhân nào xử lý, kết quả lưu ở đâu và con người kiểm tra tại bước nào. Trước khi triển khai, cần xác minh cơ chế kết nối và quyền dữ liệu của từng thành phần.
So với các dự án tương tự
| tên | sao | ngôn ngữ | giấy phép | khác nhau ở đâu |
|---|---|---|---|---|
| OpenHuman | 39293 | Rust | Không nêu trong dữ kiện | Tập trung vào bộ nhớ cá nhân ưu tiên xử lý cục bộ, điều phối tác nhân AI và nghiên cứu sâu. |
| f/prompts.chat | 167859 | HTML | Other | Tập trung vào bộ sưu tập prompt cộng đồng thay vì kiến trúc trợ lý cá nhân có bộ nhớ và điều phối tác nhân. |
| wshobson/agents | 39246 | Python | MIT License | Tập trung vào hệ sinh thái plugin/tác nhân cho nhiều môi trường phát triển và trợ lý AI. |
| NousResearch/hermes-agent | 232520 | Python | MIT License | Tập trung vào tác nhân có khả năng học hỏi và duy trì kiến thức cùng người dùng, khác với hướng bộ nhớ ưu tiên xử lý cục bộ và điều phối nhiều tác nhân của OpenHuman. |
Các số sao, ngôn ngữ và giấy phép trong bảng được lấy từ bộ dữ liệu được cung cấp cho bài viết. Không nên dùng số sao để kết luận dự án nào tốt hơn, bởi mỗi dự án giải quyết một nhóm nhu cầu khác nhau.
Về kiến trúc, OpenHuman đáng chú ý ở sự kết hợp giữa bộ nhớ cá nhân, tác nhân và quy trình nhiều bước. Nếu mục tiêu là tìm câu lệnh mẫu, một kho prompt có thể phù hợp hơn. Nếu mục tiêu là xây dựng hệ sinh thái tác nhân hoặc plugin, dự án chuyên về agent có thể đáng quan tâm hơn. Với người cần một tác nhân có khả năng phát triển cùng quá trình sử dụng, Hermes Agent là một hướng so sánh khác.
Nhận định của Việt Tiến IT
Từ góc nhìn triển khai, Việt Tiến IT cho rằng OpenHuman đáng thử khi doanh nghiệp muốn xây dựng một trợ lý AI cá nhân có ngữ cảnh dài hạn, cần tổ chức dữ liệu cá nhân và muốn thử nghiệm quy trình nhiều bước. Đây cũng là trường hợp phù hợp để bắt đầu một dự án AI và tự động hóa nhỏ, đo chất lượng rồi mới mở rộng.
OpenHuman không nên được đưa ngay vào quy trình quan trọng chỉ vì nó có khả năng điều phối nhiều tác nhân. Giai đoạn thử nghiệm đồng nghĩa doanh nghiệp cần chấp nhận việc còn góc cạnh và thay đổi trong quá trình phát triển. Những tác vụ liên quan đến dữ liệu nhạy cảm, quyết định tài chính, thông tin khách hàng hoặc hành động không thể hoàn tác nên có bước phê duyệt của con người.
Rủi ro lớn nhất khi triển khai không nằm ở việc “AI có trả lời được hay không”, mà ở dữ liệu và quyền thực thi. Doanh nghiệp cần xác định dữ liệu nào được phép đưa vào bộ nhớ, ai được truy cập, tác nhân nào được quyền thực hiện hành động và kết quả nào bắt buộc phải được kiểm tra.
Với doanh nghiệp Việt Nam, cách tiếp cận thực tế là chọn một quy trình nhỏ, dữ liệu không quá nhạy cảm và có tiêu chí đánh giá rõ ràng. Sau giai đoạn thử nghiệm, doanh nghiệp mới quyết định có cần tích hợp sâu hơn với hệ thống nội bộ hoặc phát triển phần mềm theo yêu cầu hay không.
OpenHuman vì thế đáng xem như một nền tảng để thử nghiệm mô hình trợ lý AI cá nhân + bộ nhớ + tác nhân + quy trình, thay vì xem nó là giải pháp thay thế toàn bộ nhân sự. Giá trị thực tế sẽ phụ thuộc vào cách doanh nghiệp tổ chức dữ liệu, thiết kế quy trình và kiểm soát quyền của AI.
Nguồn tham khảo ngoài: GitHub – tinyhumansai/openhuman; GitHub – NousResearch/hermes-agent; GitHub – wshobson/agents; GitHub – f/prompts.chat. Tài liệu OpenHuman mô tả bộ nhớ cục bộ, SQLite, kho Markdown tương thích Obsidian và cơ chế đồng bộ dữ liệu từ các nguồn được kết nối.
Câu hỏi thường gặp
OpenHuman phù hợp với loại công việc nào?
OpenHuman phù hợp để thử nghiệm các công việc nhiều bước như tổng hợp tài liệu, nghiên cứu, phân loại thông tin, duy trì ngữ cảnh và chuẩn bị bản nháp.
Bộ nhớ của OpenHuman được tổ chức như thế nào?
Dự án sử dụng Memory Tree cùng kho Markdown tương thích với Obsidian và SQLite để tổ chức bộ nhớ theo cấu trúc có thể xem, chỉnh sửa và quản lý.
Doanh nghiệp có nên giao ngay tác vụ quan trọng cho OpenHuman không?
Không nên. Doanh nghiệp nên bắt đầu bằng quy trình nhỏ, dữ liệu ít nhạy cảm, có tiêu chí đánh giá và bước kiểm tra của con người trước khi mở rộng quyền thực thi.
OpenHuman khác gì so với kho prompt hoặc hệ sinh thái agent?
OpenHuman tập trung vào sự kết hợp giữa bộ nhớ cá nhân, điều phối tác nhân và quy trình nhiều bước, trong khi kho prompt thiên về câu lệnh và các dự án agent có thể tập trung vào tác nhân hoặc plugin chuyên biệt.